
De Dev Web à Ingénieur IA #1
Setup complet de l'environnement : Docker, Ollama, PostgreSQL, pgvector, TypeScript

Je suis développeur fullstack TypeScript (React, Node, React Native). Pas data scientist, pas ingénieur ML. Mais l'IA agentique devient un sujet incontournable pour tout développeur, et j'ai décidé de l'apprendre par la pratique.
L'objectif de ce blog : documenter le chemin d'un dev web vers l'ingénierie IA, avec une stack 100% locale et open-source.
Prérequis
Si tu es dev web, tu as probablement déjà tout ça :
Node.js v22+ — vérifie avec
node --versionDocker Desktop — pour PostgreSQL
Ollama — le moteur LLM local
Qu'est-ce qu'un LLM local ? Au lieu d'envoyer tes données à OpenAI ou Claude, le modèle tourne sur ta machine. Sans clé API, sans abonnement.
Installation : curl -fsSL https://ollama.com/install.sh | sh
Puis vérifie avec : ollama --version
curl -fsSL https://ollama.com/install.sh | sh
ollama --version
Quel modèle choisir ?
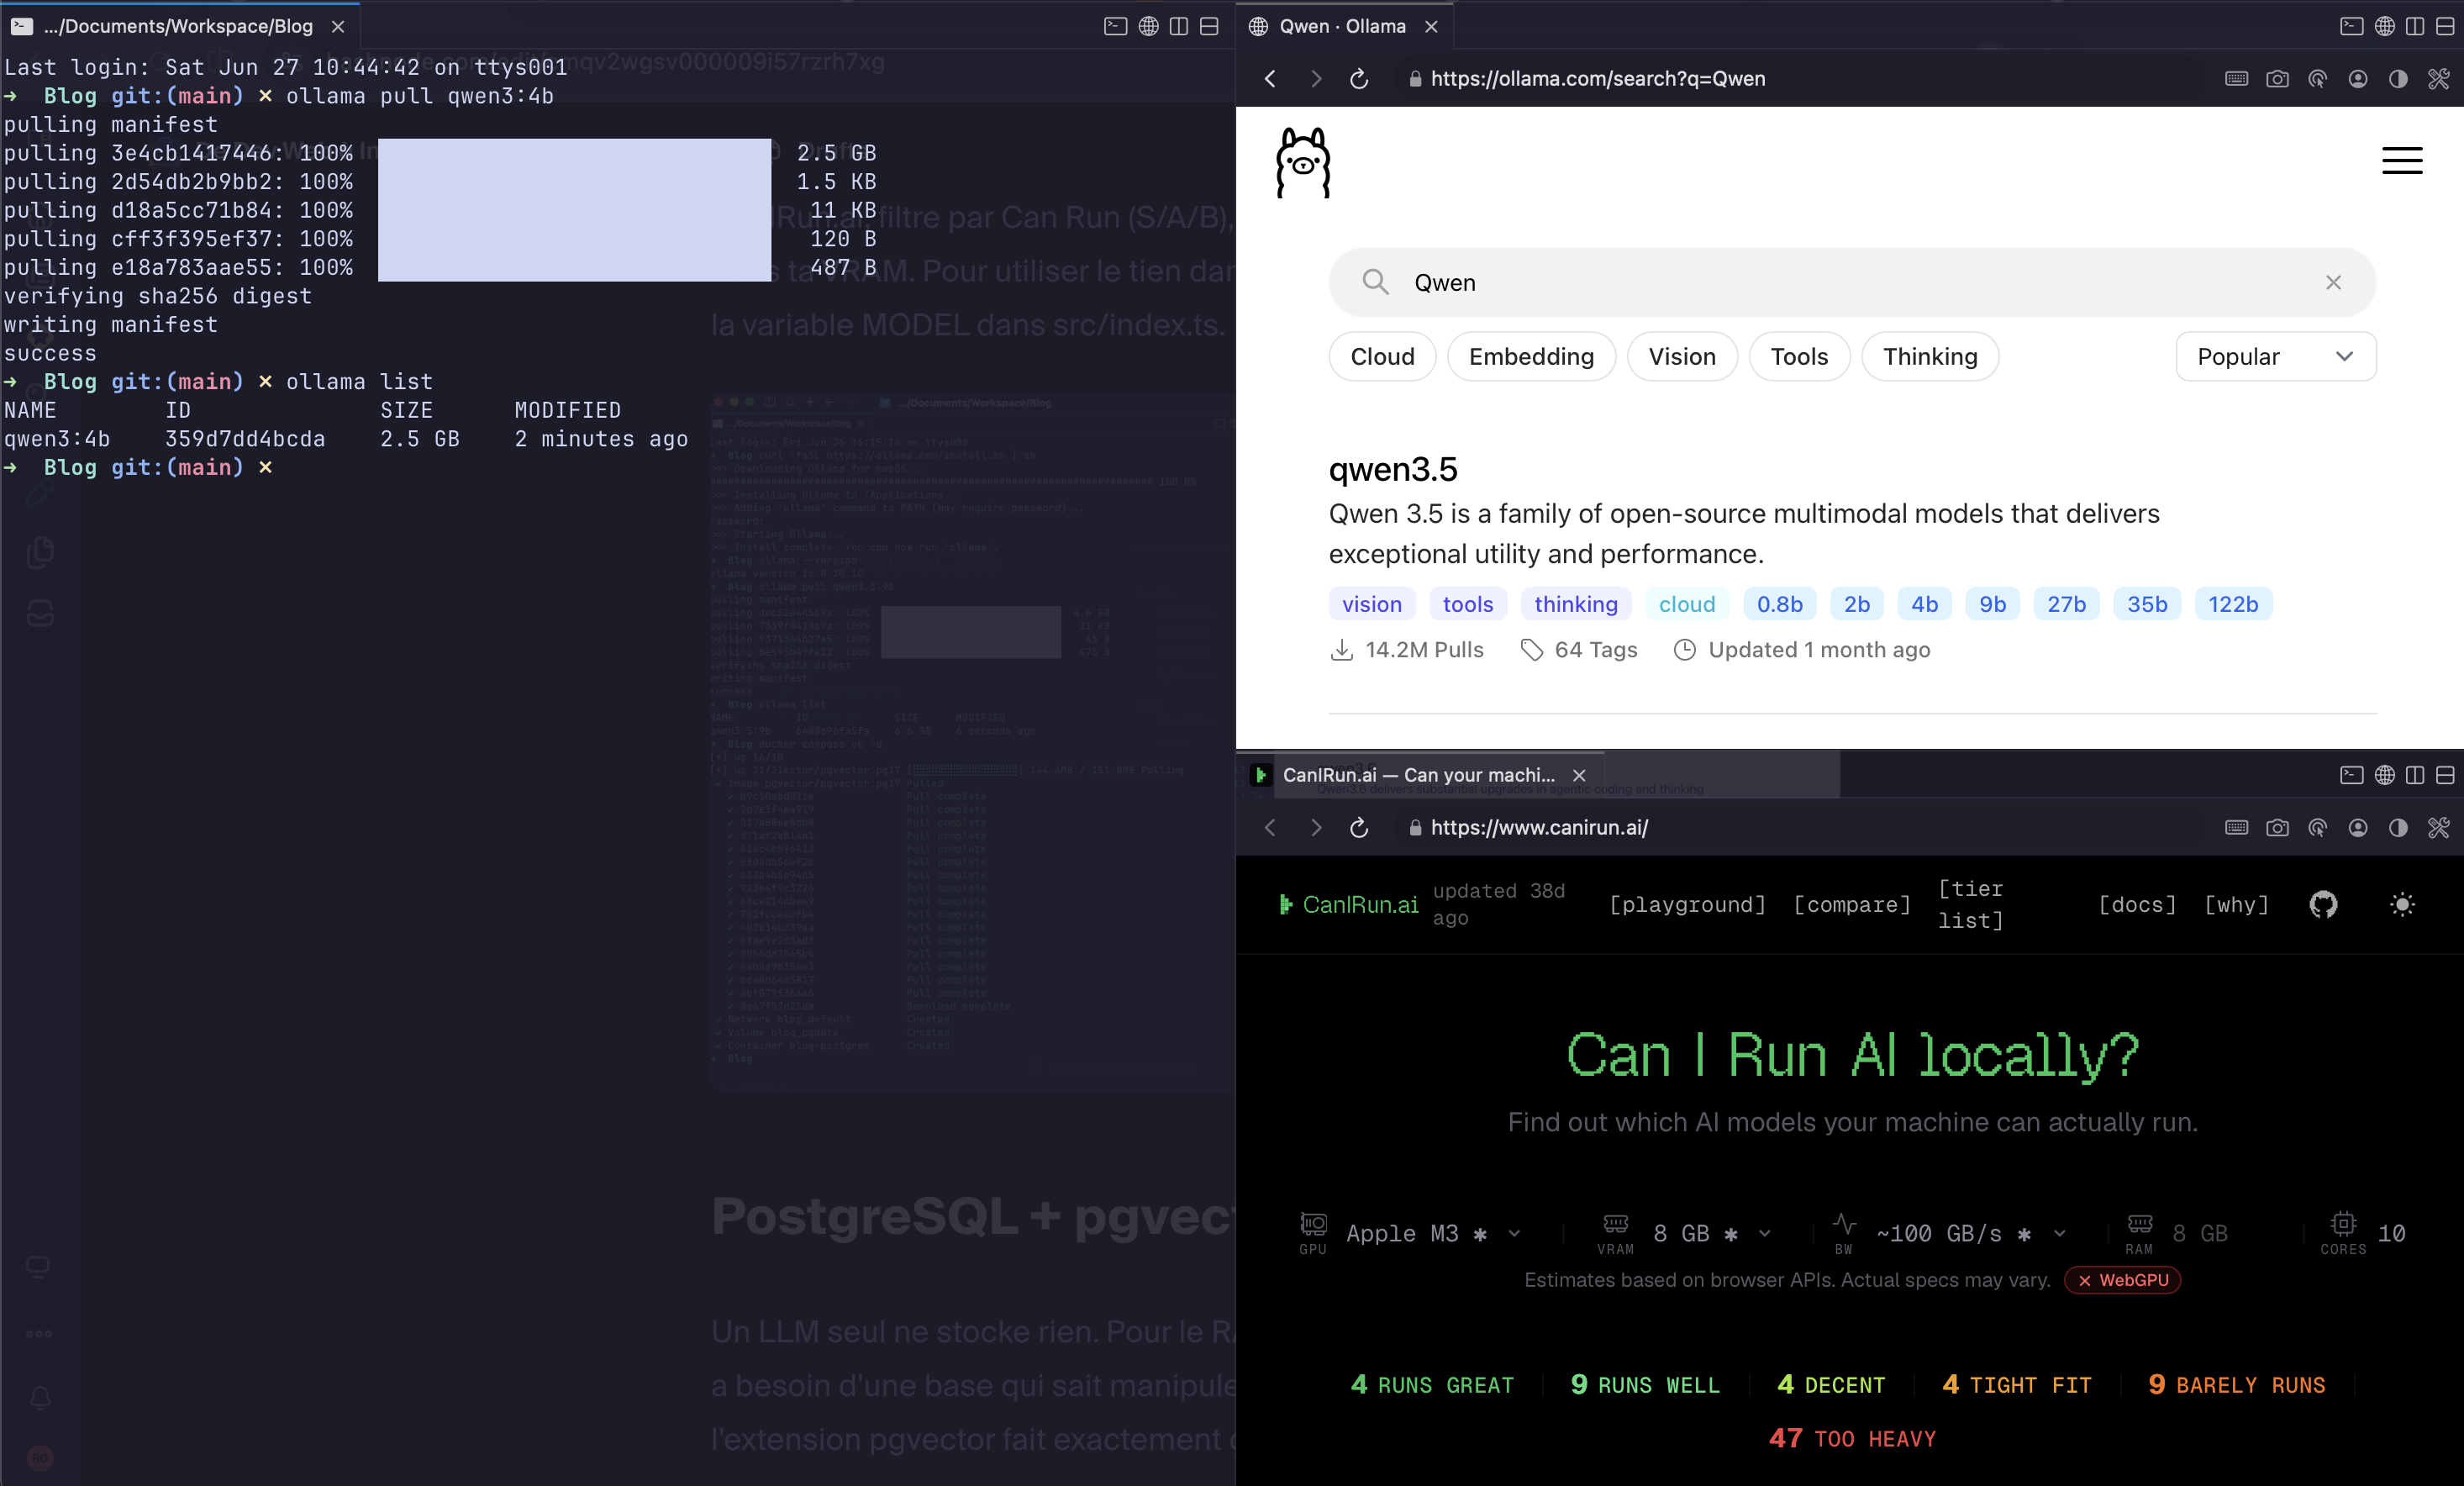
Tous les modèles ne tiennent pas sur toutes les machines. Avant de choisir, passe par CanIRun.ai (https://www.canirun.ai) — un site gratuit qui scanne ta machine depuis le navigateur (Chrome/Edge) et liste les modèles compatibles avec leur RAM consommée et leur vitesse estimée en tok/s.
Pour mon MacBook Air M2 16 Go, CanIRun classe les 7B en Tight Fit (51% VRAM) et les 4B en Can Run (31%). Le 4B tient intégralement dans la mémoire GPU sans swap, ce qui évite tout crash. Je suis donc parti sur Qwen 3 4B (2.5 Go, 26 tok/s), un modèle compact qui supporte le tool calling et le mode reasoning. On le télécharge avec :
ollama pull qwen3:4b
Le modèle parfait pour toi n'est pas forcément le mien. Rends-toi sur CanIRun.ai, filtre par Can Run (S/A/B), et choisis le plus gros modèle qui tient dans ta VRAM. Pour utiliser le tien dans le reste de la série, il suffira de changer la variable MODEL dans src/index.ts.
PostgreSQL + pgvector — la base vectorielle
Un LLM seul ne stocke rien. Pour le RAG (qu'on verra plus loin dans la série), on a besoin d'une base qui sait manipuler des vecteurs. PostgreSQL avec l'extension pgvector fait exactement ça.
On crée un fichier docker-compose.yml à la racine du projet :
services:
  postgres:
    image: pgvector/pgvector:pg17
    container_name: blog-postgres
    ports:
      - "5432:5432"
    environment:
      POSTGRES_USER: blog
      POSTGRES_PASSWORD: blog
      POSTGRES_DB: blog
    volumes:
      - pgdata:/var/lib/postgresql/data

volumes:
  pgdata:
Puis on lance :
docker compose up -d
Vérifie avec docker ps que le container est bien lancé.
Projet TypeScript — structure et validation
Chaque article de la série a son propre dossier indépendant (package.json, tsconfig.json, src/). Aucune dépendance croisée, chaque lecteur peut piocher un article sans avoir à tout installer.
Initialisation
mkdir -p article-01-setup/src && cd article-01-setup
touch tsconfig.json src/index.ts
npm init -y
npm i pg
npm i -D @types/node @types/pg tsx typescript
tsconfig.json
{
  "compilerOptions": {
    "target": "ES2022",
    "module": "NodeNext",
    "moduleResolution": "NodeNext",
    "strict": true,
    "esModuleInterop": true,
    "skipLibCheck": true,
    "types": ["node"]
  },
  "include": ["src/**/*.ts"]
}
Script de validation (src/index.ts)
import pg from "pg"

const MODEL = "qwen3:4b"
const OLLAMA_BASE = process.env.OLLAMA_HOST ?? "http://localhost:11434"

interface ChatMessage {
  role: "system" | "user" | "assistant"
  content: string
}

interface LLMResponse {
  message: ChatMessage
}

async function chat(model: string, messages: ChatMessage[]) {
  const res = await fetch(`${OLLAMA_BASE}/api/chat`, {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({ model, messages, stream: false }),
  })
  return res.json() as Promise<LLMResponse>
}

async function main() {
  console.log(`\n=== Setup Dev — Vérification de l'environnement ===\n`)

  console.log(`1. Test LLM (${MODEL})...`)
  const res = await chat(MODEL, [
    { role: "user", content: "Réponds en une phrase : qu'est-ce qu'un LLM ?" },
  ])
  console.log(`   ✅ Ollama répond : ${res.message.content}\n`)

  console.log("2. Test PostgreSQL...")
  const pool = new pg.Pool({
    host: process.env.PGHOST ?? "localhost",
    port: Number(process.env.PGPORT) || 5432,
    user: process.env.PGUSER ?? "blog",
    password: process.env.PGPASSWORD ?? "blog",
    database: process.env.PGDATABASE ?? "blog",
  })
  const pgRes = await pool.query("SELECT version()")
  console.log(`   ✅ PostgreSQL connecté : ${pgRes.rows[0].version}\n`)

  console.log("3. Test pgvector...")
  await pool.query("CREATE EXTENSION IF NOT EXISTS vector")
  const vRes = await pool.query(
    "SELECT extname, extversion FROM pg_extension WHERE extname = 'vector'"
  )
  console.log(`   ✅ Extension pgvector : \({vRes.rows[0].extname} v\){vRes.rows[0].extversion}\n`)

  await pool.end()
  console.log("=== Tout est OK, l'environnement est prêt ! ===")
}

main().catch((err) => {
  console.error("❌ Erreur :", err.message)
  process.exit(1)
})
Lancer le script
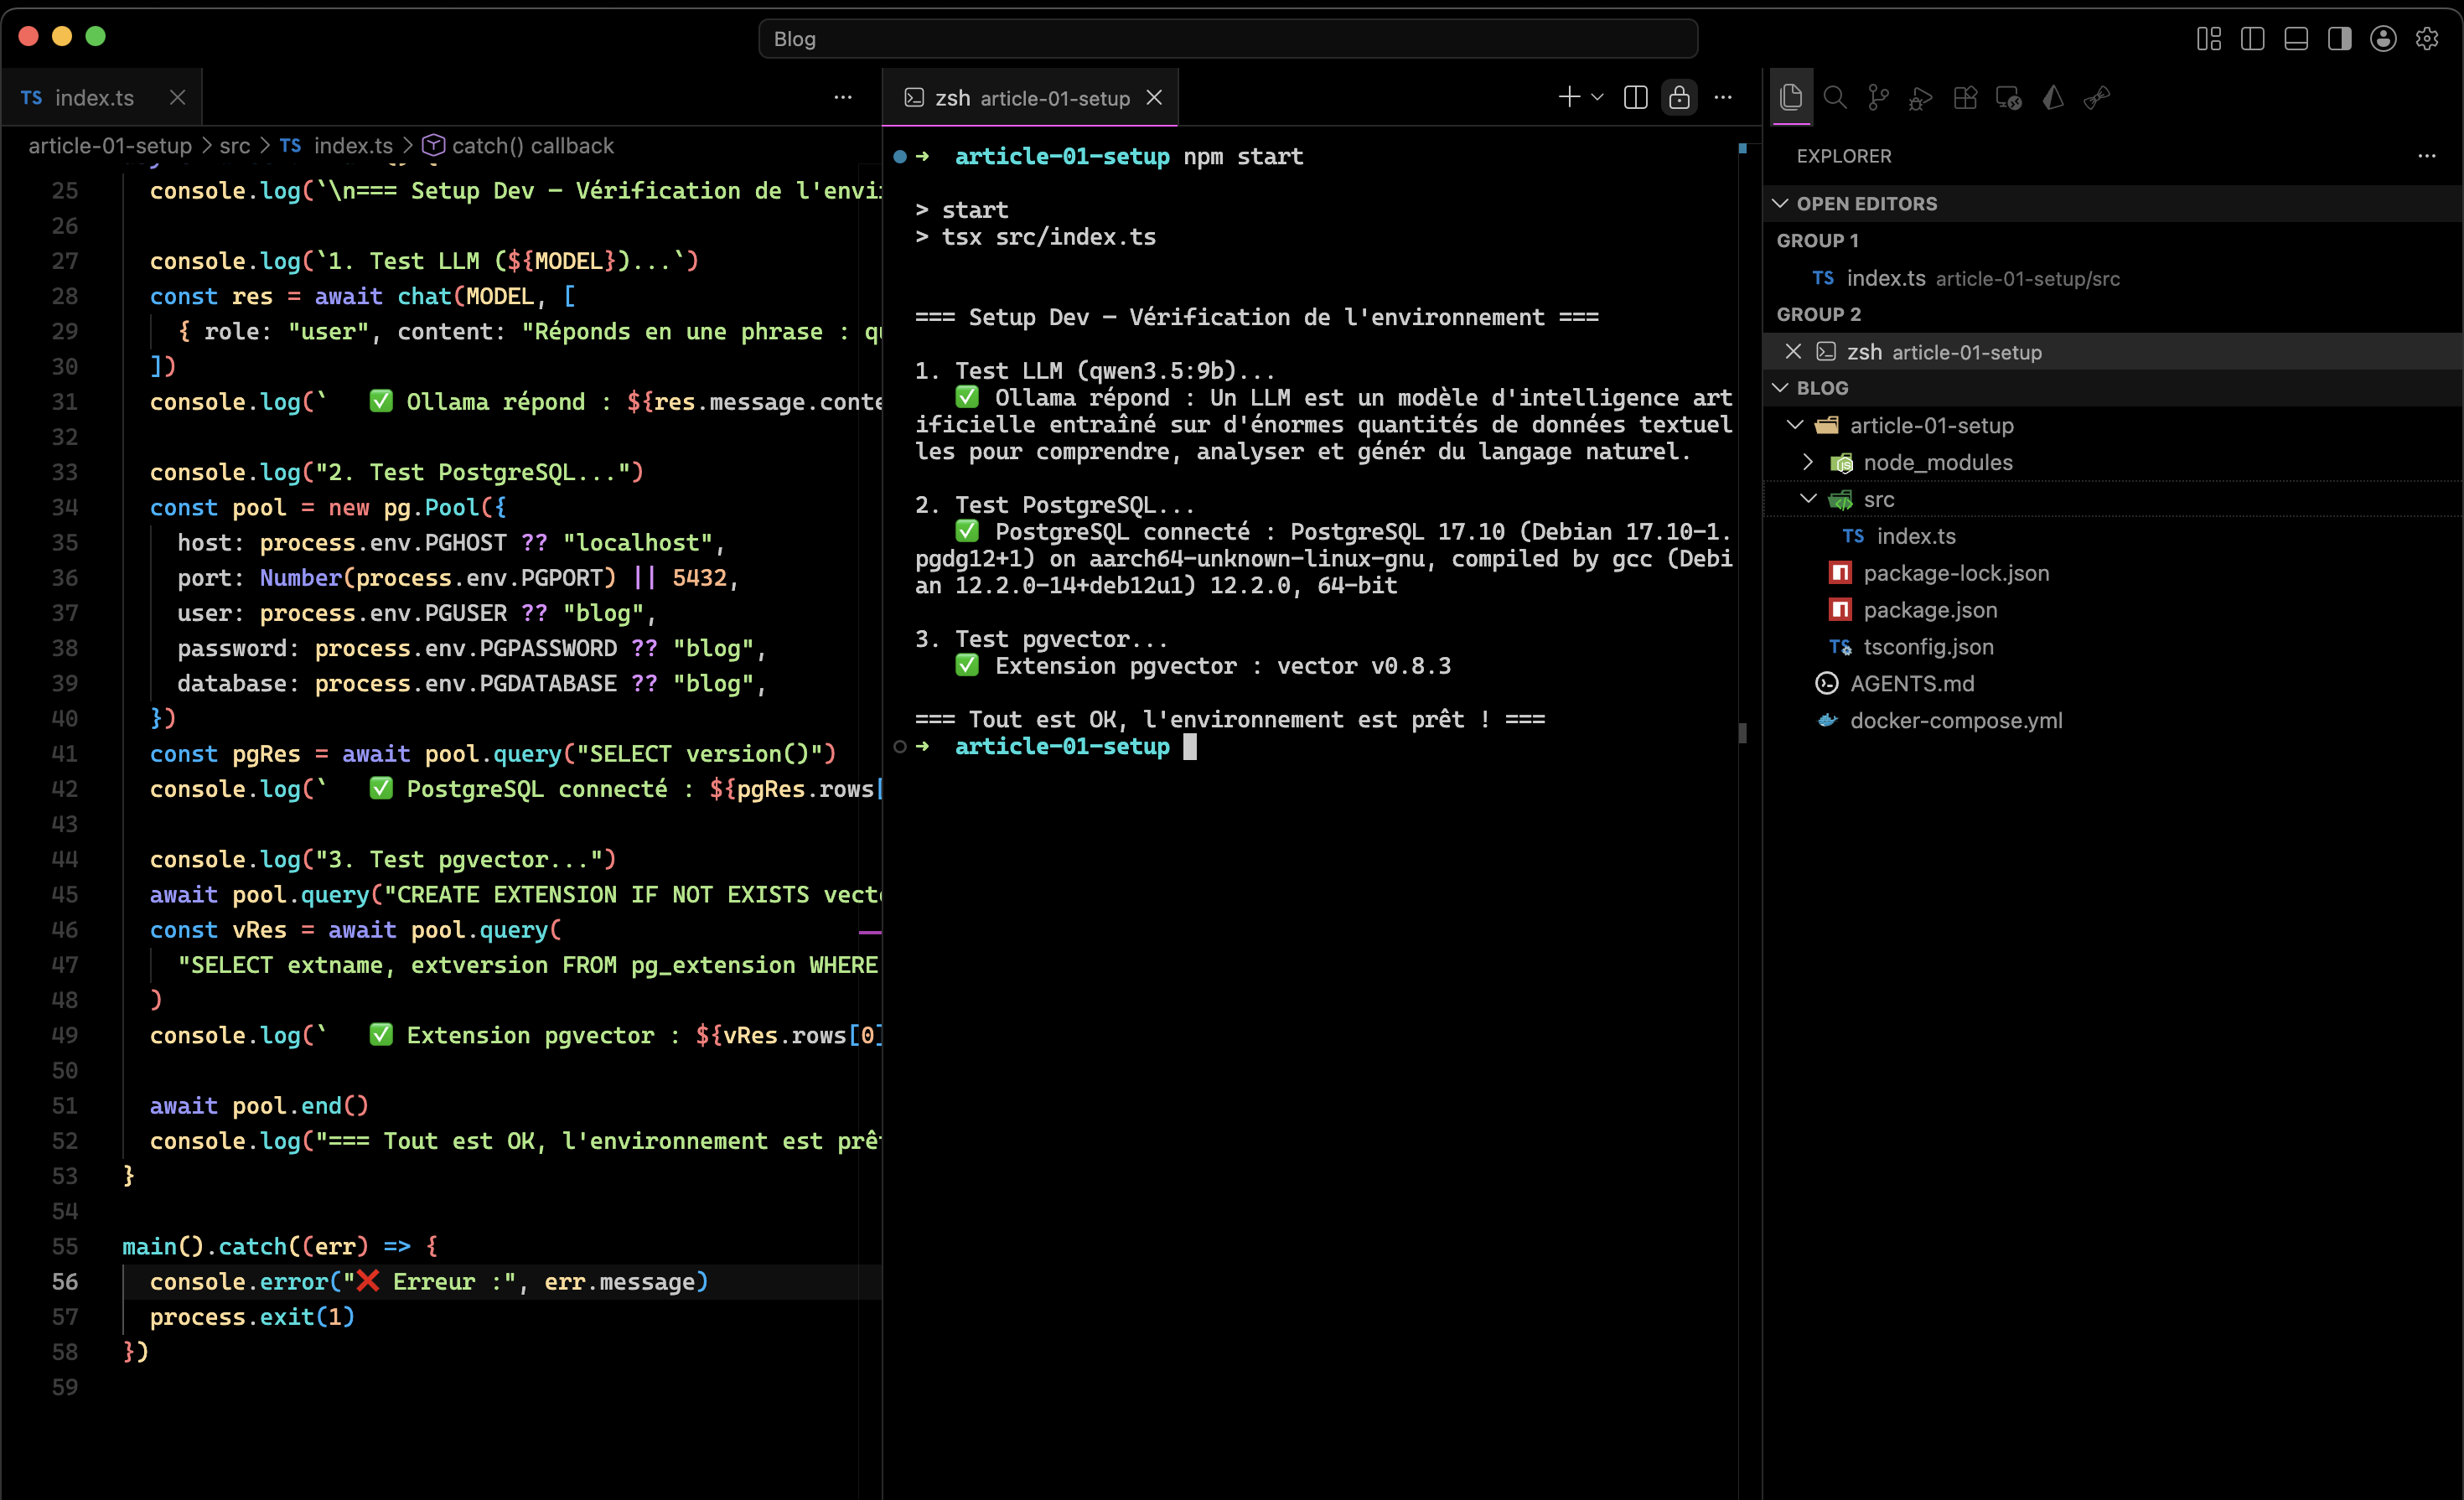
npm start
Explication du code
Le script fait trois vérifications simples.
Appel à Ollama — on envoie une requête à l'API /api/chat d'Ollama avec un message utilisateur. Pas de SDK, juste fetch. La réponse contient le texte généré par le modèle.
Connexion PostgreSQL — on crée un pool de connexions avec les identifiants définis dans le docker-compose.yml. Une simple requête SELECT version() confirme que la base répond.
Extension pgvector — on active l'extension vectorielle avec CREATE EXTENSION IF NOT EXISTS vector, puis on vérifie qu'elle est bien présente. C'est tout ce dont on aura besoin pour stocker et rechercher des embeddings dans les articles suivants.
Chaque étape affiche ✅ en cas de succès. Si une seule échoue, le script s'arrête et affiche l'erreur.
Conclusion
Le setup est terminé. On a :
Ollama avec
qwen3:4b— le moteur LLM localPostgreSQL 17 + pgvector 0.8.3 — la base vectorielle
Un projet TypeScript qui servira de modèle pour les articles suivants
Toute la stack est locale, gratuite, et open-source. Chaque article de la série sera indépendant mais reprendra cette base. Pas besoin de tout refaire à chaque fois : le plus long est déjà fait.
Prochain article : Premier appel LLM et prompt engineering — comprendre le rôle des system prompts, la température, et structurer une conversation avec Ollama.


